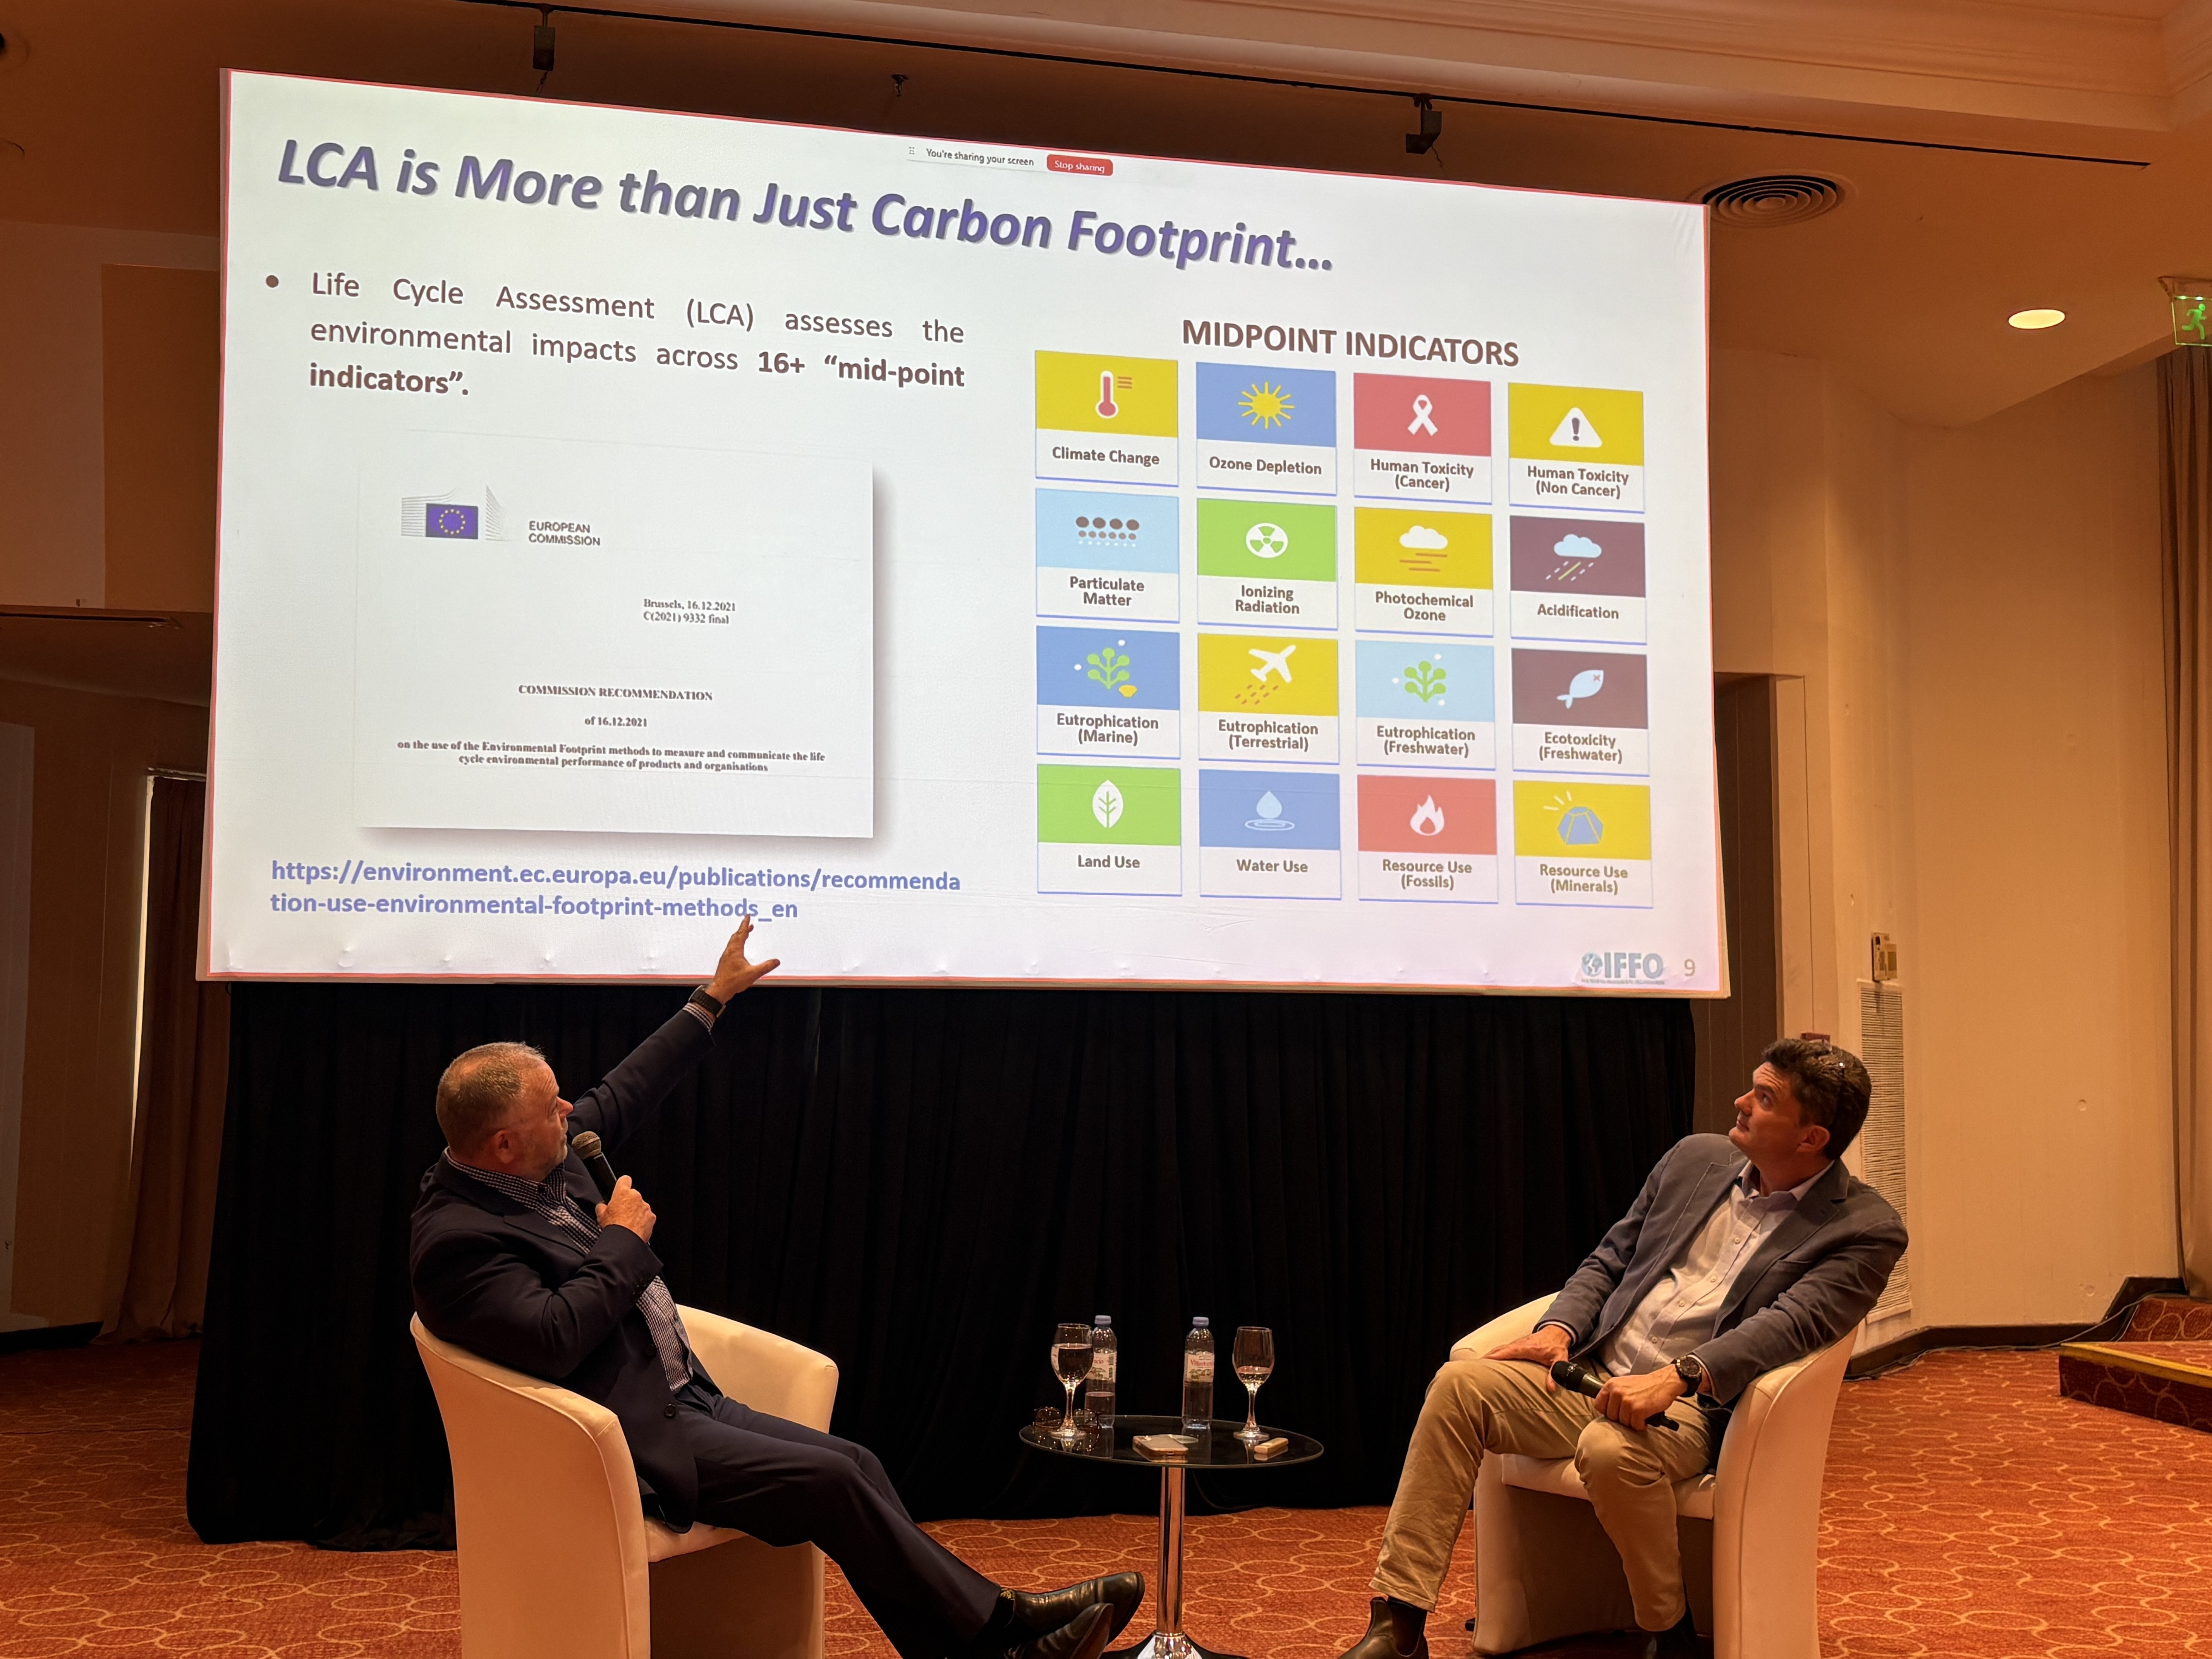
10月21日, IFFO在布宜诺斯艾利斯举行的年度大会期间,举办了专场边会,从饲料行业和海洋原料行业的视角探讨可持续发展与产品全生命周期评估(LCA)的需求。
全球饲料生命周期评估研究所(GFLI)执行主任Delanie Kellon的演讲介绍了GFLI的角色,即提供一个可全球访问、持续更新的动物饲料原料生命周期评估(LCA)数据库,支持对饲料原料进行合规、可信且透明的环境评估。GFLI在国际指导框架下不断推进发展,并与会员企业及行业协会合作,推动行业改进。
GFLI数据库收录了超过1800种饲料原料的LCA指标,其评估方法符合联合国粮农组织(FAO)的LEAP(畜牧业环境评估和绩效伙伴关系)以及欧盟PEFCR(产品环境足迹类别规则)等饲料指南标准。此外,GFLI还构建了涵盖饲料原料生产全过程(从源头到工厂入口)的系统边界评估体系。完整的环境足迹包含16个以上的影响类别,数据集基于各类统计资料和二手数据来源,或汇总的原始数据。目前采用三种分配方法(质量、经济和能源),并提供三种不同格式,使用户能够通过饲料配方、基准值或可持续性报告等多种方式访问数据。
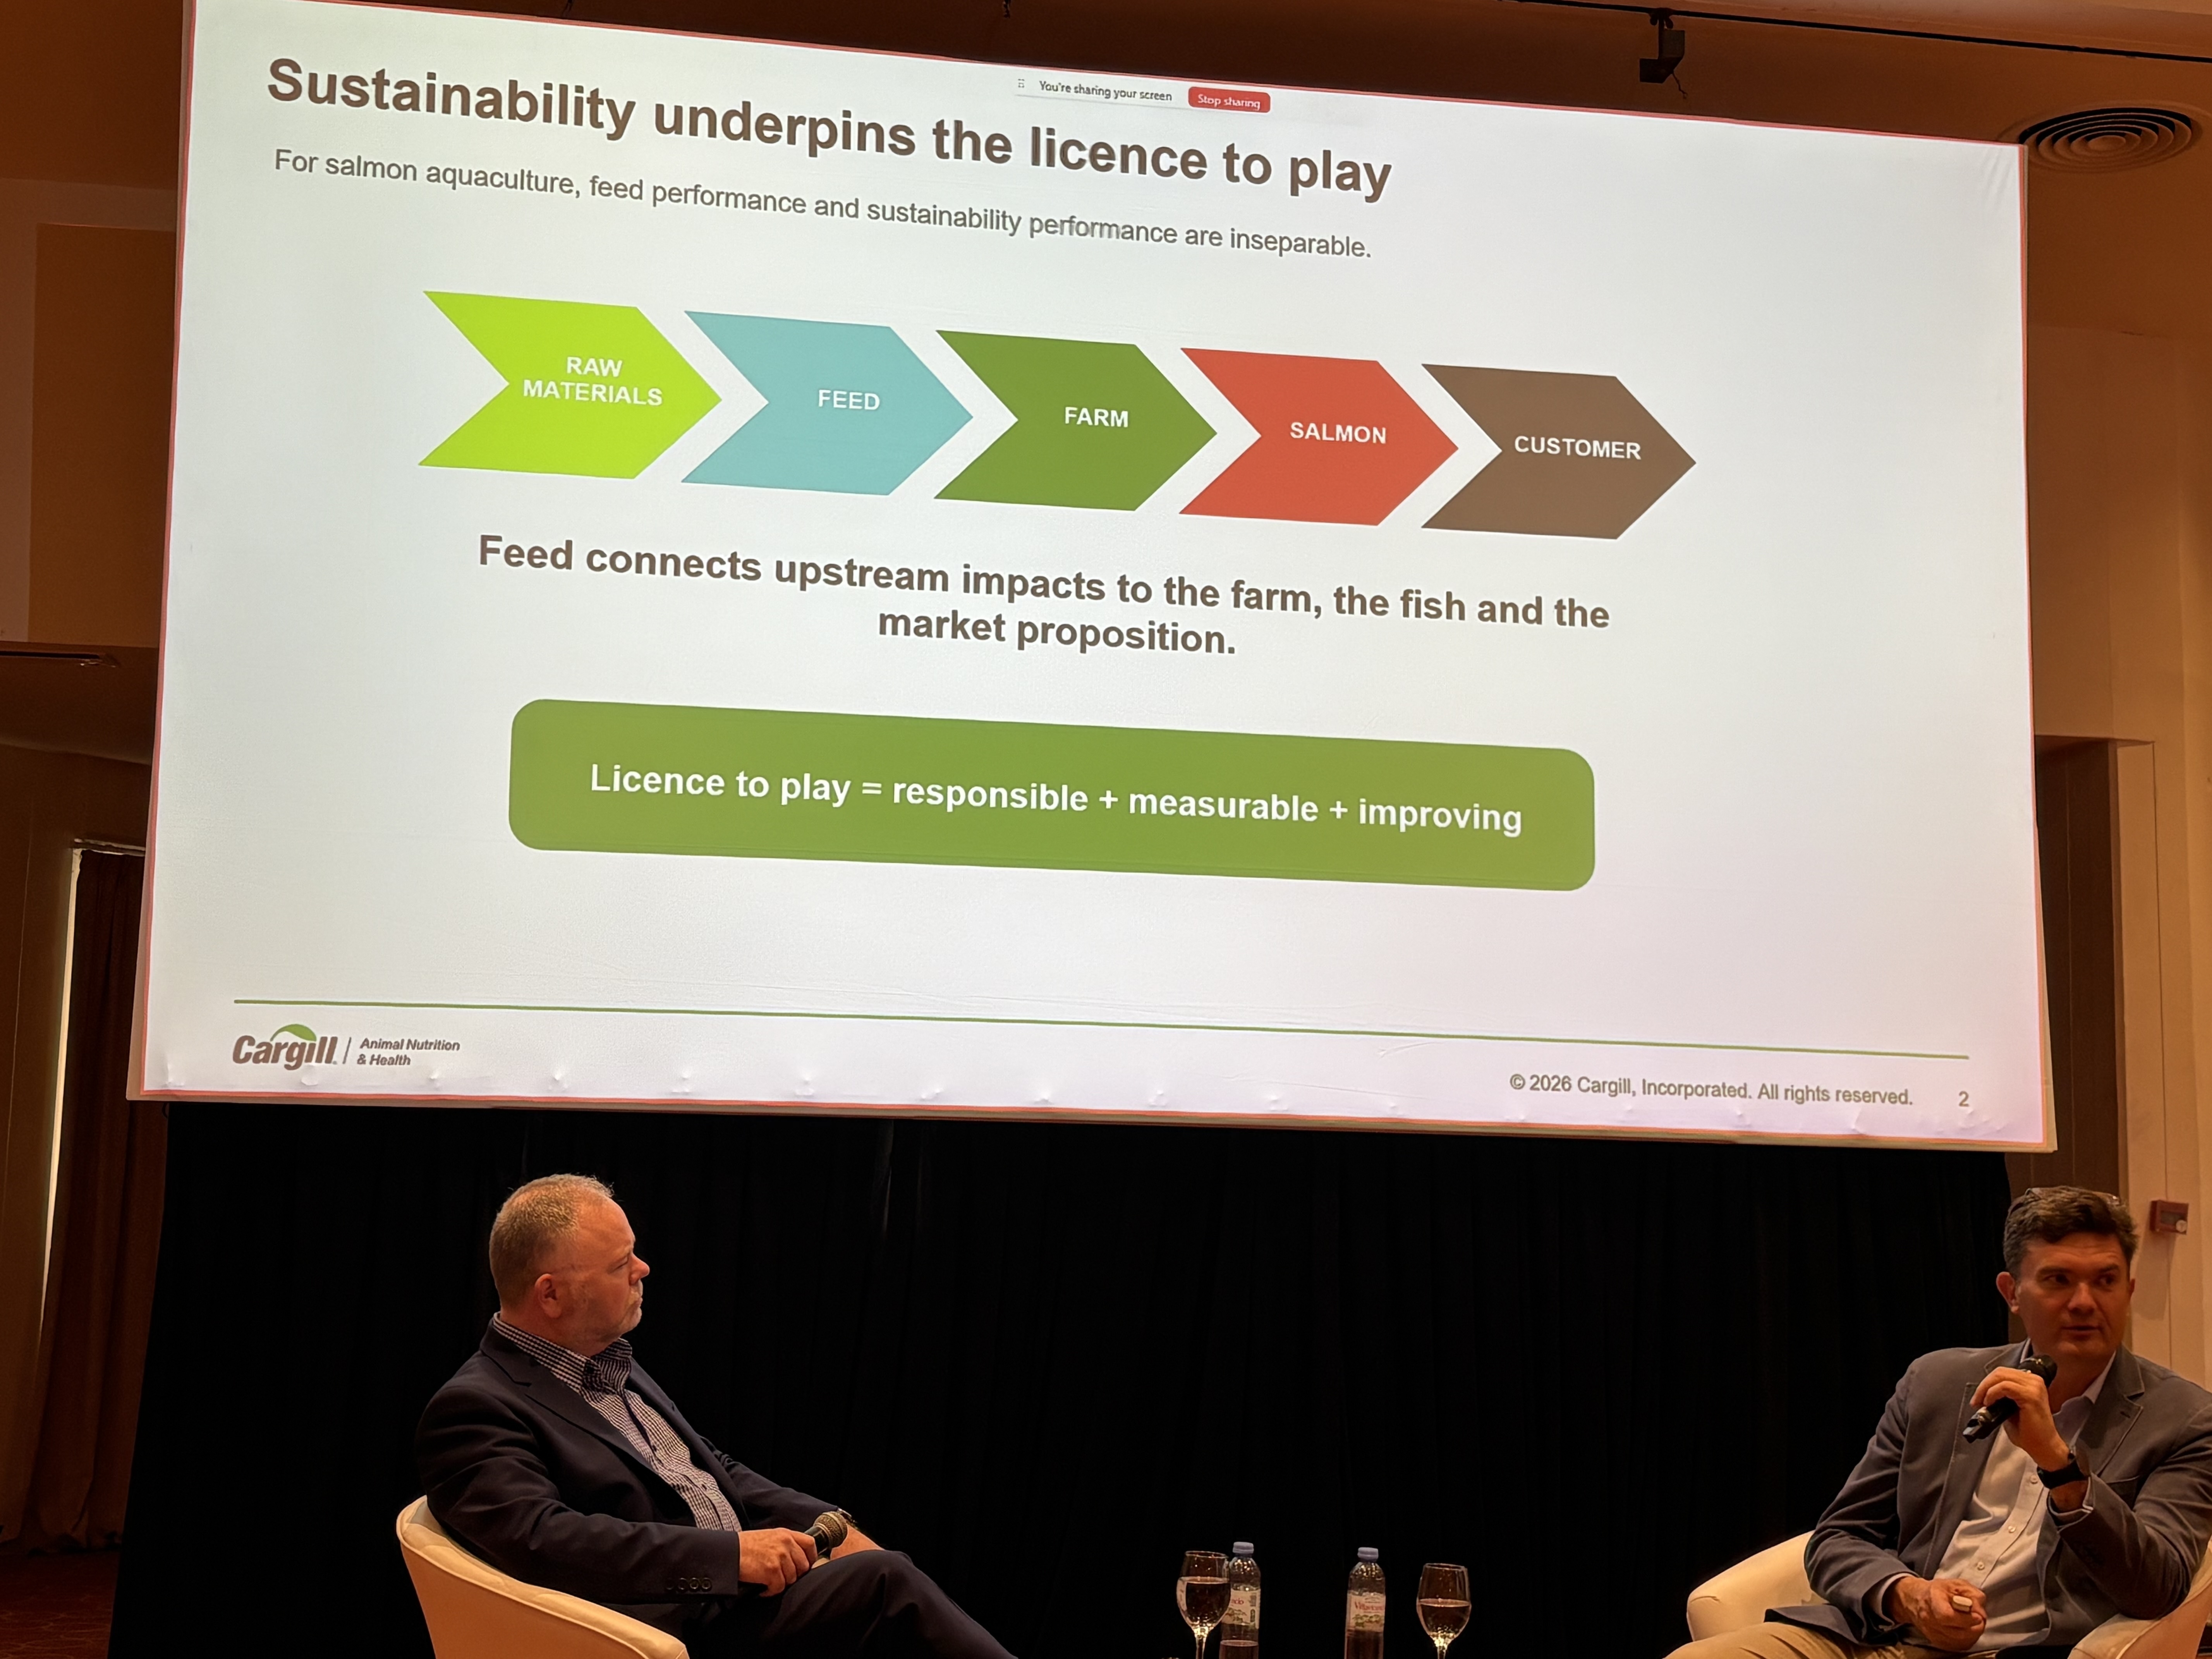
饲料可持续性许可
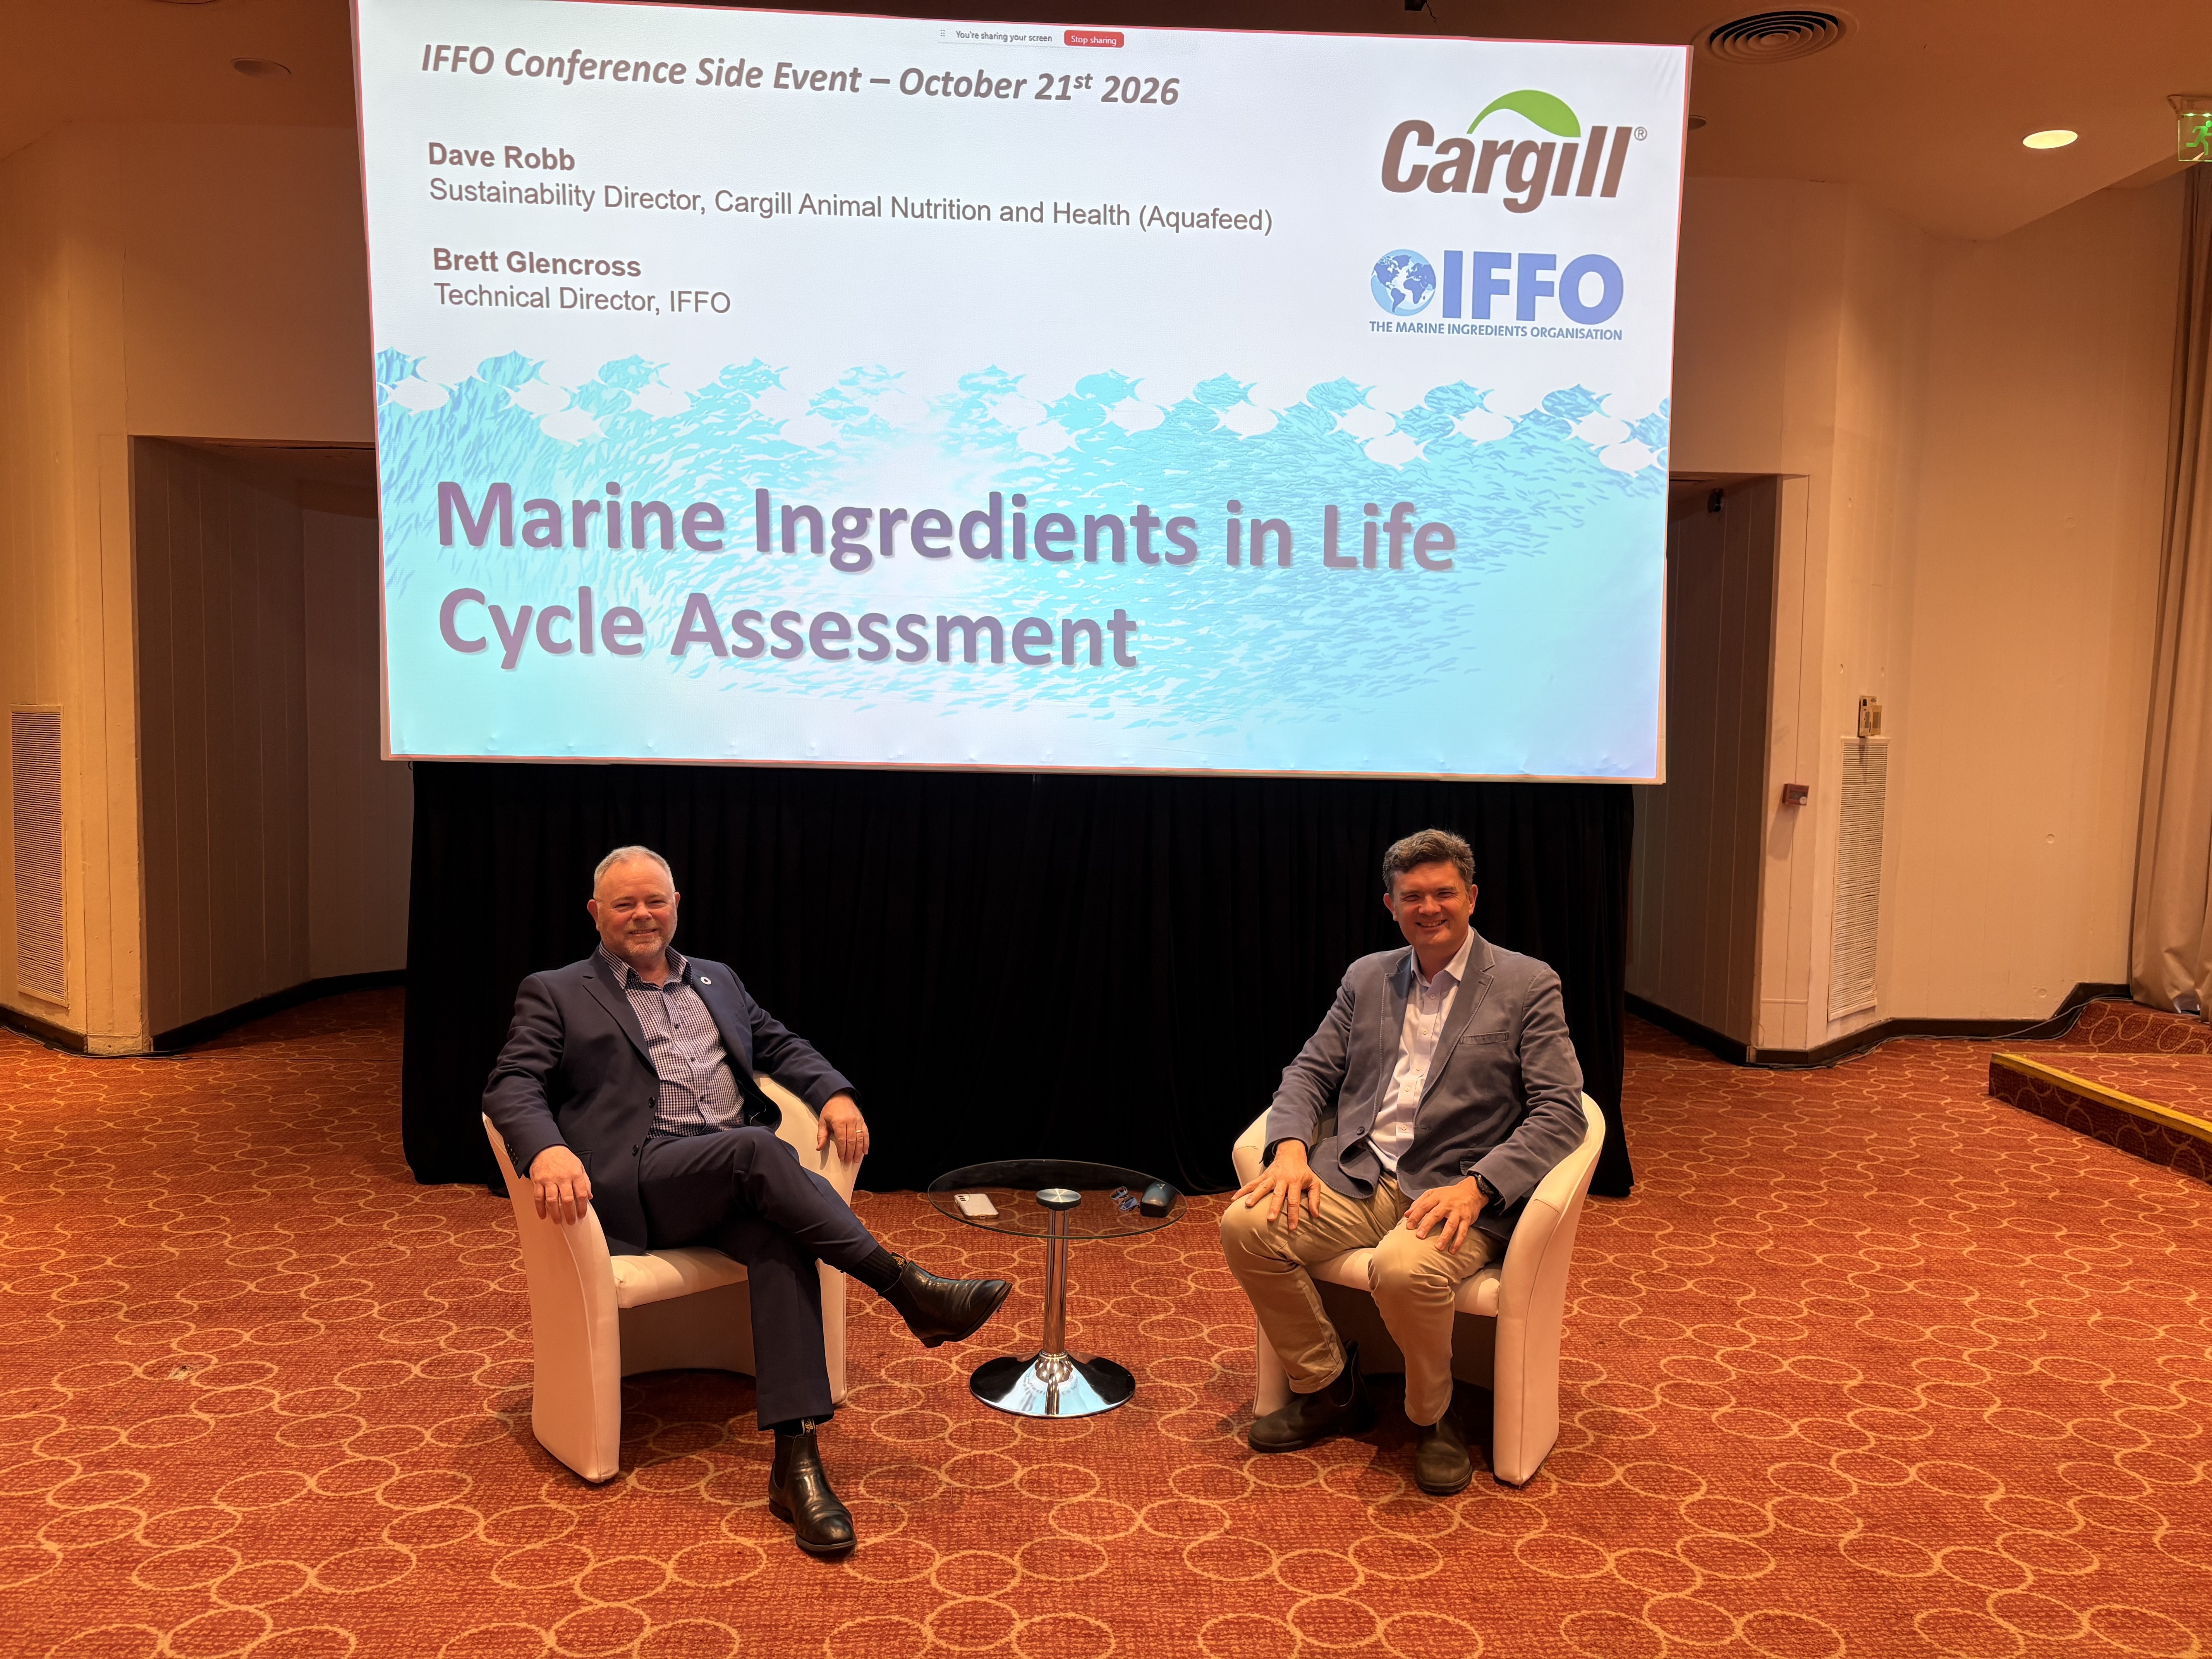
嘉吉动物营养与健康可持续发展(水产营养业务)总监David Robb分享了饲料及整个价值链中的可持续发展见解。过去20年,水产养殖业的格局已发生巨大变化:人们对需求和压力的认识日益加深,饲料配方也变得更加多样化。Robb指出:“可持续性已成为行业运营的许可,饲料必须在价值链中提供负责任的解决方案。过去,行业从海洋原料转向大豆,这带来了更多压力;如今,随着向其他新型原料的转型,我们将不再专注于单一成分,而需确保配方负责任。”过去,饲料配方主要关注营养成分和最低成本的原材料。如今,除了营养和价格之外,我们还采取整体性方法,致力于寻找能够促进健康、促进生长,并在全价值链中减少影响的饲料。
嘉吉的可持续发展策略也不断演进,确保我们在原料及其来源方面进行充分尽职调查,并通过供应链中的适当认证来加强这一过程,验证基础环节的落实情况。
影响在哪里
以鲑鱼为例,其碳足迹中有85%来自饲料及饲料使用,这主要受饲料转化率(FCR)和鱼类健康状况的影响,进而影响到用于生产饲料的原材料。不同原料组合对环境影响有显著差异,其中海洋原料的碳足迹通常远低于植物蛋白。数据的应用有助于降低或明确碳足迹计算,使决策更加科学,并实现更顺畅的产业链数据整合。
你只能管理你所测量的事物
Brett Glencross (葛柏峦)指出,必须能够公平地评估原料的碳足迹,并通过标准化框架来实现这一目标,同时也有助于更有效地衡量进展。他强调了过去20年欧洲水产养殖业生产方式的变化,随着减少对海洋原料依赖的努力,原材料已大幅转向以植物蛋白和油脂为主。随着海洋原料使用减少,碳足迹、土地利用、用水量及其他关键指标均有所上升,而这一变化的主要原因在于过度关注单一指标:即“鱼投入产出比”(FIFO)。
葛柏峦补充道:“生命周期评估(LCA)远不止于碳足迹,在欧洲,企业必须依法采用这种方法来证明其可持续性。16项以上影响类别的数据差异很大。尽管该方法仍在不断完善,且相关科学尚处于初级阶段,但LCA正成为未来最佳的发展方向。随着我们不断收集数据,越来越意识到,产品在来源、加工工艺甚至收获时间等方面都可能存在巨大差异。”
如何映射和跟踪影响:从摇篮到大门
环境影响不仅发生在生产环节,还必须从原材料开采(捕获)、加工、分销、消费/使用以及废弃物处置等全过程进行追踪。明确系统的范围(边界)至关重要,因此IFFO专注于对海洋原料生产进行从“摇篮到大门”(即离开生产者时)的分析。葛柏峦指出,由于生产流程的多样性,例如直接的人类消费等,IFFO已绘制出五个不同的系统边界和流程。
挑战在于将这些不同系统中的数据标准化为每吨鱼类的数据,以确保数据的可用性。葛柏峦补充道:“数据收集面临巨大挑战,因为GFLI和PEFCR规定我们必须采用1%的‘门槛’标准,这意味着所有贡献超过1%的原料都必须纳入评估。”Robb指出:“我们需要一种统一的方法论,而我们选择的正是我们认为最符合价值链和原料供应商需求的方法。这也鼓励了更多副产品被使用。我们的供应商现在能够清楚地看到自己可以在哪些方面以及如何推动改进。”
IFFO的数据收集
IFFO已为各企业创建了一个初级数据收集的Excel模板,涵盖五个系统的关键数据要素:加工、精炼、捕捞以及运输环节。这些数据随后输入Simapro——这一生命周期评估(LCA)标准软件,使企业能够对数据进行映射和访问。Simapro不仅可追踪碳足迹,还能分析土地利用、臭氧层损耗、水资源消耗甚至生态毒性,从而拓展对各类原料的讨论范围。有趣的是,较高的油产量通常意味着较低的碳足迹,且不同捕捞方法的影响也各不相同,其中围网捕鱼方式的碳足迹更低。由于分配方式将捕捞碳足迹与鱼片及副产品分开计算,因此副产品的碳足迹也显著降低。IFFO的工作正帮助数据库从2023年涵盖32种产品的50个数据集扩展至2026年涵盖52种产品的370个数据集,从而改善了跨行业的比较,并基于实际行业活动生成这些数据集。